星凡智能高君效:端侧AI竞争正在从峰值算力转向系统效率
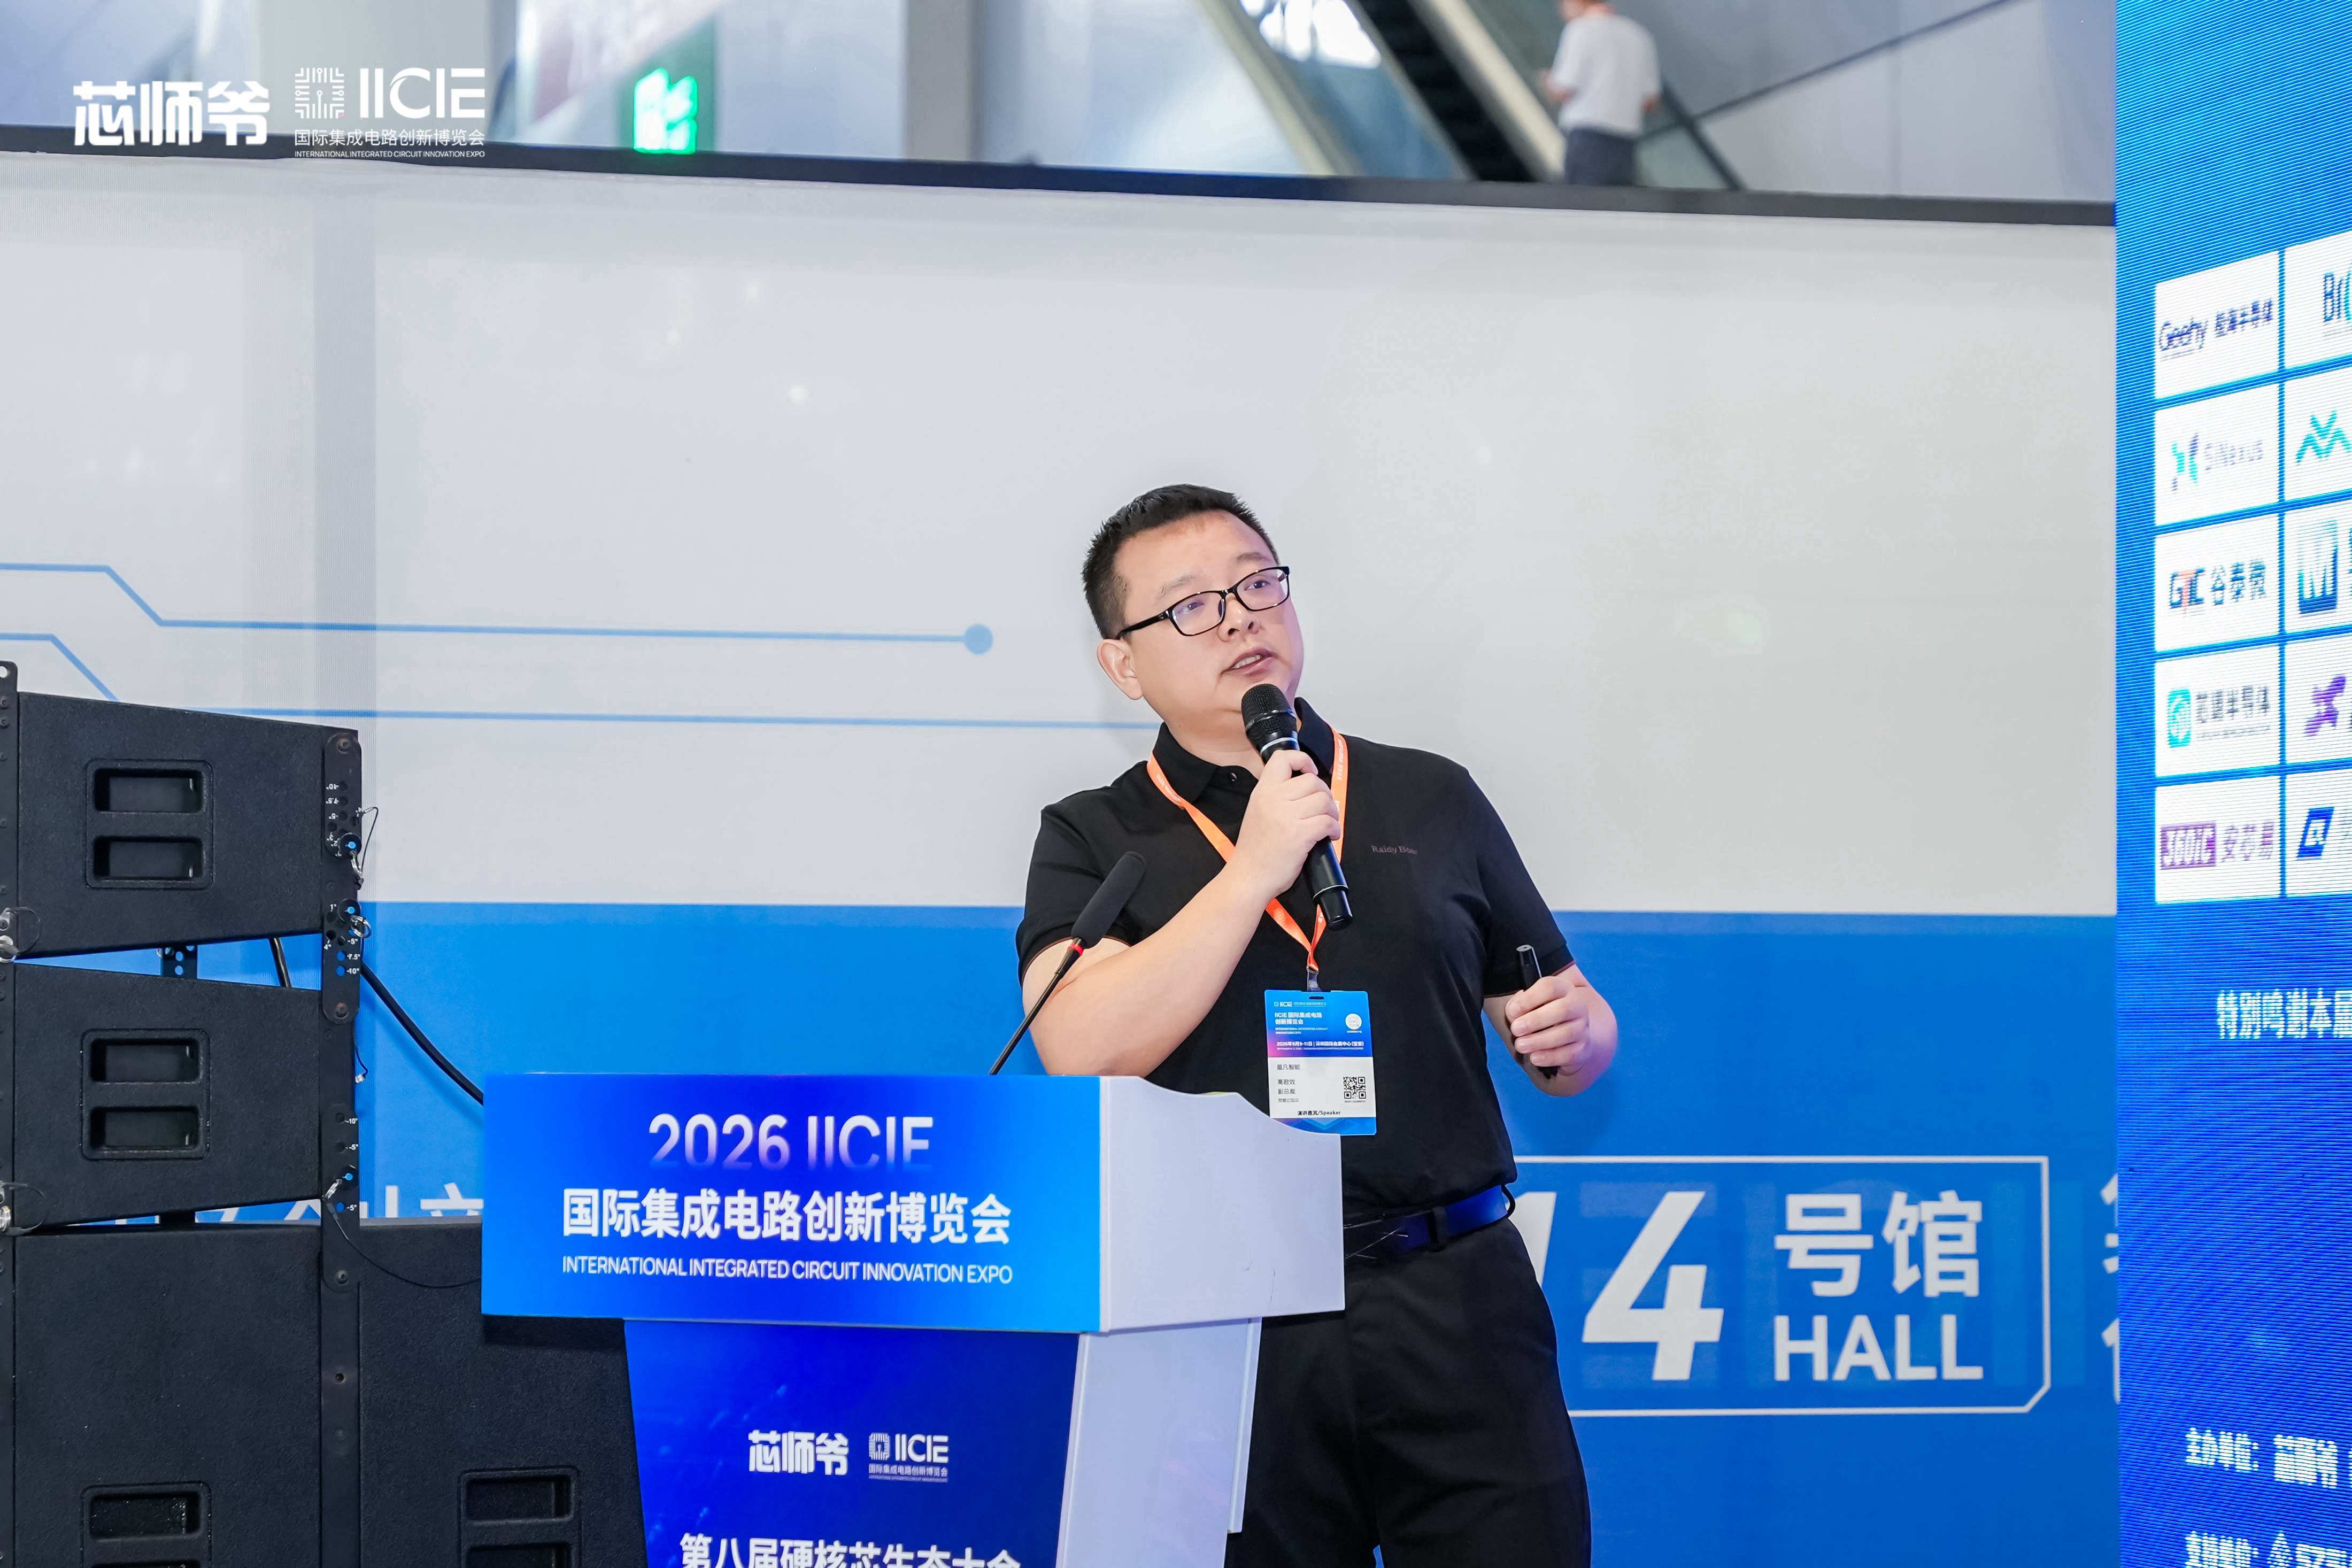
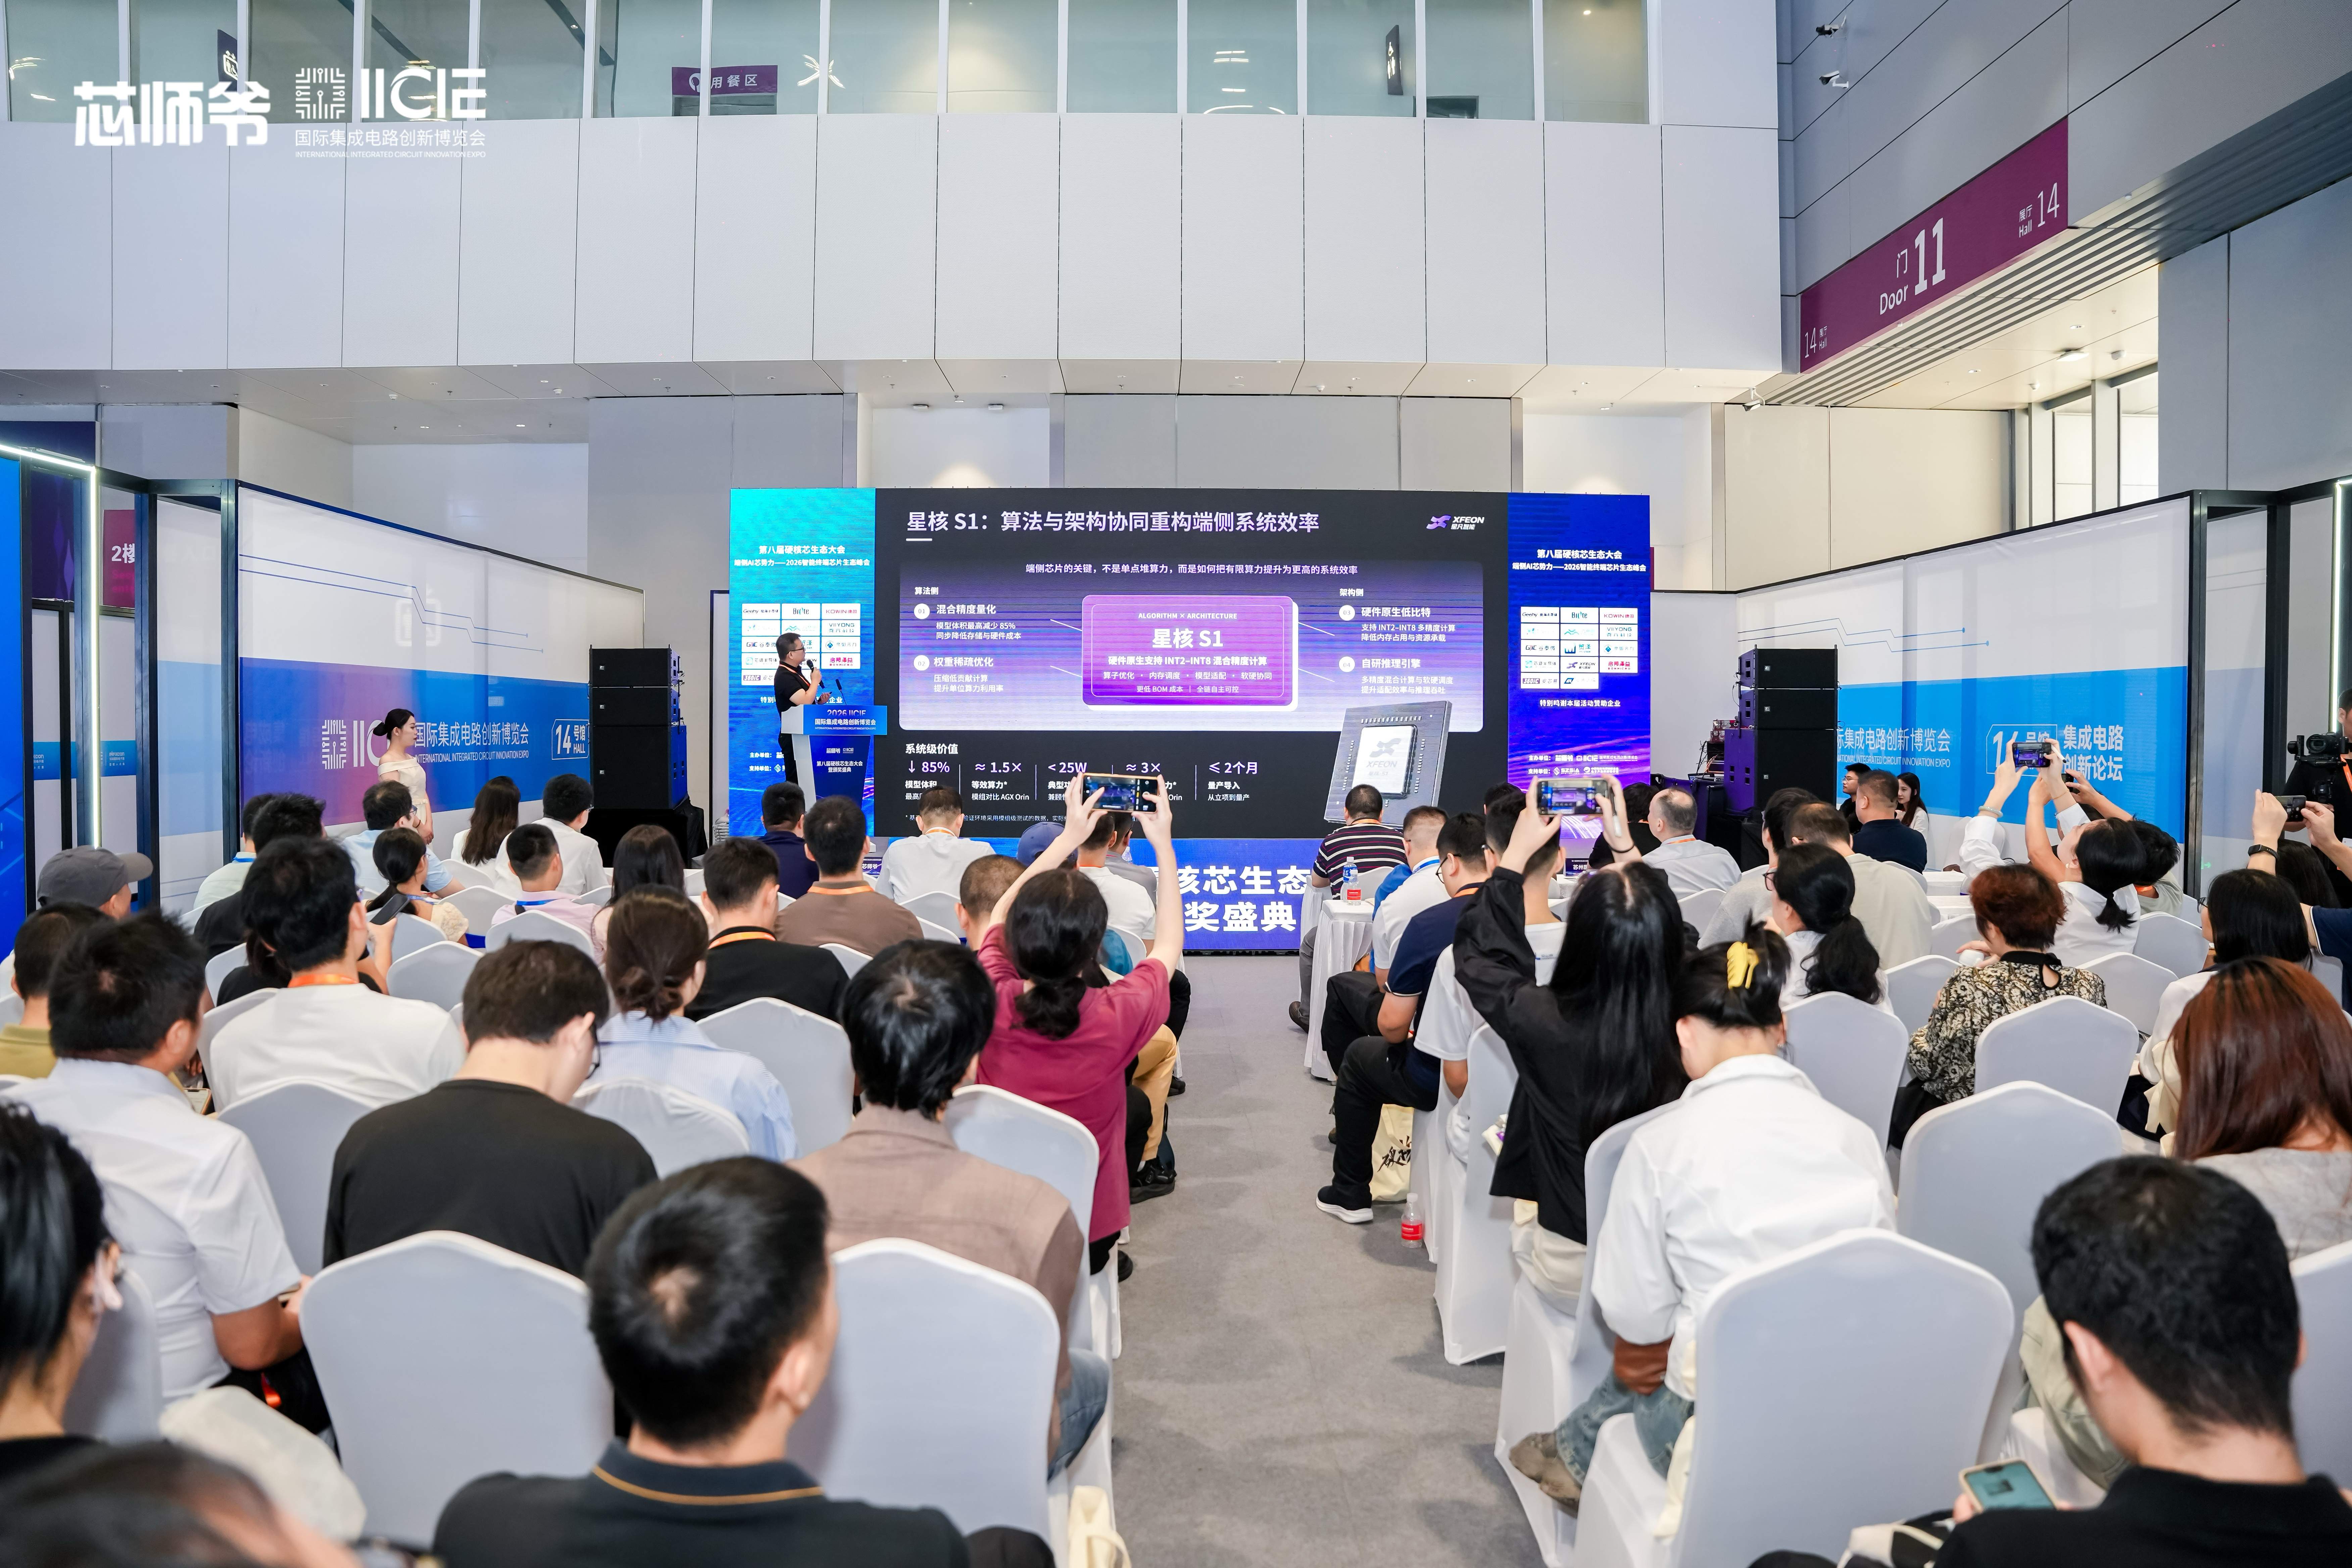
9月10日,在“端侧AI芯势力——2026智能终端芯片生态峰会”上,星凡智能合伙人、副总裁高君效发表《智赋万物,芯创未来——物理AI时代的端侧芯片机遇》主题演讲,以端侧芯片领域的研发和产业实践为基础,分享了物理AI时代的芯片发展趋势。
成都星核芯光半导体有限公司是星凡智能(XFEON)旗下专注于物理AI端侧芯片研发与产业化的半导体企业,围绕机器人、卫星、无人系统和边缘设备的实际运行需求,构建从底层芯片到场景化算力产品的技术体系。
高君效拥有近20年集成电路研发及管理经验,曾主导商业化终端人工智能语音芯片的研发与生产,相关芯片累计出货超过千万颗。基于长期芯片研发与量产实践,他在演讲中提出:“端侧AI的竞争,不再只是峰值算力之争,而是每一瓦功耗、每一份存储、每一次响应,能够产生多少有效智能。”
AI从Token走向Action,端侧芯片需要重新定义
当AI主要运行在数据中心时,行业更关注模型参数、算力规模和峰值性能。但随着AI进入机器人、无人机、卫星和边缘设备,计算环境正在发生变化。
物理终端不仅要处理视觉、语音、环境和运动等多模态信息,还需要及时完成推理、决策与控制。机器人要根据环境变化调整动作,卫星要在轨识别、筛选和处理数据,无人设备还要在有限的供电、散热和存储条件下保持稳定运行。
物理世界不会等待云端响应。高君效将云端与端侧的关系概括为:“云端决定智能的能力上限,端侧决定智能能否在现场及时发生。”
因此,物理AI需要的不是简单地把云端算力搬到终端,而是在有限资源下获得更高的实际算效。算力、功耗、存储、模型适配和响应速度,需要在同一套系统中取得平衡。
这也是星核芯光研发端侧芯片的基本逻辑:不以单一峰值参数定义芯片,而是从模型能否在真实设备上长期、稳定、高效运行出发,反向设计芯片架构和软件体系。
星核芯光物理 AI 端侧芯片:星核 S1
围绕物理AI终端对算力和能效的综合要求,星核芯光自主研发了星核S1物理AI端侧芯片。星核S1采用定制多核架构和自研AI算法加速内核,单芯粒提供105 TOPS INT8等效算力,典型功耗约25W,能效比超过4 TOPS/W,并支持多路视频编解码。
与先完成芯片设计、再由软件和算法进行适配的传统路径不同,星核S1从模型在物理终端上的实际运行需求出发,对算法、芯片架构、数据通路、推理引擎和软件栈进行协同设计,可实现推理吞吐量提升50%、模型显存占用减少85%、持续学习显存占用降低90%。
在计算精度方面,星核S1硬件原生支持INT2、INT3、INT4、INT6和INT8混合精度计算,可以根据不同模型、不同网络层对精度的敏感程度,灵活配置计算格式,在尽量保持模型效果的同时减少计算量和存储开销。
在算力利用方面,星核S1结合低比特量化和稀疏优化,减少低贡献计算,让有限的硬件资源更多地用于有效推理。配合自研推理引擎以及星凡智能体系内的XBoost端侧优化能力,还可以从算子优化、量化压缩和软硬件调度等环节进一步释放芯片性能。
让更大参数规模的模型进入机器人、卫星和边缘设备,降低终端对高功耗硬件和云端连接的依赖,同时减少模型部署所需的显存、功耗与硬件成本。
从星核S1到星核R、K系列,把芯片能力转化为场景价值
一颗芯片要真正进入产业,还需要针对不同设备的功耗、接口、存储和任务需求,形成可以直接部署的计算产品。
以星核S1为底层核心,星核芯光进一步构建了面向具身智能的星核R系列与面向太空计算的星核K系列。
星核R系列面向机器人本体智能,将多模态感知、本地大模型推理、任务规划和实时控制部署到机器人本地。R70(P)提供70 TOPS整形算力和105 TOPS INT8等效算力,适用于机器人视觉感知、语义理解和实时决策;R280(P)提供280 TOPS整形算力和420 TOPS INT8等效算力,最高支持128GB内存,可承载多传感器融合、本地大模型运行与复杂任务规划。相比依赖云端完成推理,星核R系列可以缩短机器人从感知到控制的处理链路,减少网络状态对任务执行的影响,同时降低本体厂商在芯片、模型和软件栈之间反复适配的成本。目前,R系列已进入机器人客户适配和量产导入前验证阶段。
星核K系列则将端侧智能从地面延伸到太空。传统卫星主要负责采集和回传数据,大量原始数据需要传回地面后再进行分析,低价值数据同样会占用有限的星地通信带宽。星核K系列支持遥感分析、目标识别、数据筛选和智能压缩,使卫星能够对采集数据“先理解、再下传”。其中,K200可提供210 TOPS算力,功耗约90W;K300可提供300 TOPS算力,功耗约120W,能效比达到2.5 TOPS/W。通过将部分智能处理能力前移至卫星端,星核K系列可以减少无效数据回传,提升在轨任务的实时性,并降低关键任务对地面链路和外部算力的依赖。相关产品正在围绕星上推理、遥感数据在轨处理和星地协同计算推进应用,并参与“星算计划”生态建设。
依托母品牌星凡智能四类底层能力,构建物理AI持续进化闭环
星核芯光解决的是物理AI如何在端侧高效运行的问题,但智能进入真实世界,仅有芯片还不够。模型需要从真实任务中获取数据,数据需要经过处理和训练,形成的智能能力还要重新部署到机器人、卫星等物理终端。
围绕这一过程,星凡智能构建了覆盖芯片、数据、算力与算法的物理AI产品矩阵。作为星凡智能旗下专注于物理AI端侧芯片研发与产业化的半导体企业,星核芯光以星核S1为底层算力核心,形成面向机器人本体智能的星核R系列和面向卫星在轨智能的星核K系列,让模型能够在不同物理终端本地运行和实时决策。
在数据侧,星凡智能构建了由具身智能训练场、XGAIA DataFlow、XGAIA Operator与DexCore仿真一体机组成的数据产品体系,贯通真实数据采集、仿真数据生成、数据治理、任务执行与反馈回流。
在算力侧,星辉D/N系列Token工作站面向大模型训练、推理和规模化部署。其中,D系列侧重国产化部署、政企私有化与行业大模型应用,N系列面向高性能训练、高并发推理和Token算力工厂。两条产品线融合多芯片生态、自研量化算法和XBoost加速能力,支持BF16至INT2多格式混合精度量化,模型体积最高可缩减85%。一台8卡星辉系列Token工作站可以承载671B参数大模型,无需建设大型计算集群即可运行,软硬一体化交付最快7天上线。目前,星凡智能累计交付等效算力已超过数千P。
在算法侧,星凡智能发布AGLobe星凡具身大脑与XBoost加速平台端侧版。AGLobe以概念学习为核心,尝试从少量甚至一条示教数据中提取可以迁移、组合和复用的任务概念,让机器人从“复现一个动作”走向“学会一类任务”。当物体、位置、环境或任务目标发生变化时,机器人可以调用和组合已有能力,减少相似任务的重复采集与训练。XBoost则覆盖模型压缩、混合精度量化、算子优化、推理引擎和硬件适配,并兼容PyTorch、ONNX、vLLM等主流框架及开源模型生态。在指定模型和硬件环境下,XBoost可实现2至8倍综合性能提升,部分场景推理吞吐量最高提升10倍;模型体积可由约720GB压缩至约200GB,硬件适配周期可由数周缩短至小时级。
在这套产品体系中,真实世界数据为模型提供持续学习的经验,Token算力将数据转化为可训练、可部署的模型能力,AGLobe与XBoost形成智能与加速能力,星核S1及R、K系列再将这些能力部署到机器人、卫星等物理终端。终端完成任务后产生新的数据,重新进入下一轮处理和训练,由此形成“端侧运行—数据回流—模型进化—能力部署—任务执行”的持续进化闭环。每一次Action,既是本轮智能能力的输出,也是下一轮智能进化的起点。
从自主端侧芯片到数据、算法与Token算力,星凡智能旗下星核芯光所依托的已不再是某一项孤立技术,而是一套贯通物理AI关键环节的底层能力体系。基于芯片研发、产品落地与系统协同方面的持续积累,9月10日下午,星核芯光在“智算之源:2026芯算力创新峰会暨第八届硬核芯颁奖盛典”上获得“2026年度卓越成长表现企业奖”。本届评选由50万名工程师参与评分和投票,并结合100位专家评委的专业评审产生,这一奖项也从产业侧印证了星核芯光从底层芯片研发向场景化产品和规模化应用持续推进的成长路径。
当AI从数字世界走进真实世界,决定竞争结果的可能不再是某一项孤立参数,而是谁能让模型、芯片与终端高效协同。
星核芯光给出的答案,从星核S1开始,并正在延伸至更加广阔的物理世界。
相关阅读